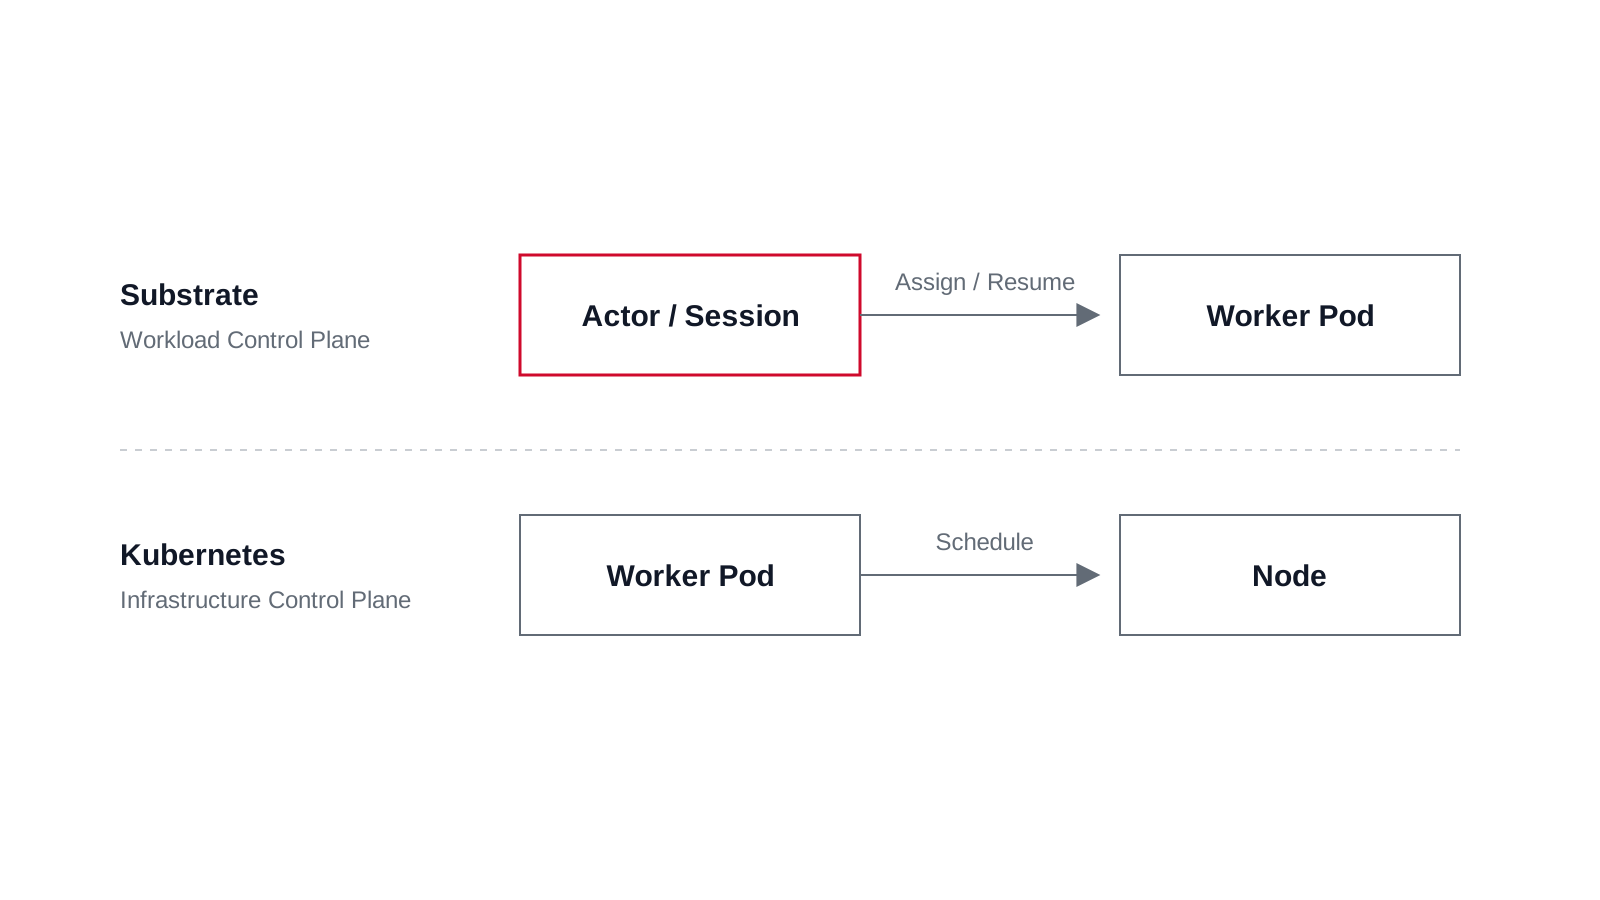
当我们去看以 substrate 为例的 Agent Infra 的架构,容易产生一个疑问:Kubernetes 已经有 API server、scheduler 和 kubelet,为什么上面又出现了 ateapi、Actor scheduler、atelet 和一套网络路由?Agent Infra 是在重新写一遍 Kubernetes 吗?
组件名称的相似,掩盖了调度对象的变化。Kubernetes 把 Pod 放到 Node 上;Substrate 把有身份、有状态的 Actor 放到已经运行的 Worker 上。这层设计首先把逻辑工作负载的生命周期与 Pod 分开,再把频繁的激活和休眠交给专门的控制面处理。
Actor 与 Worker 的生命周期
一个 Agent 可以存在几天,却只在收到消息时执行片刻。让它始终占据一个 Pod,内存、运行时和 Pod 槽位会随逻辑实例数增长;每次活动都重建 Pod,又要支付控制器协调、调度和启动成本,还必须回答进程状态从哪里继续。Warm Pool 能提前支付启动成本,但如果会话仍长期绑定实例,空闲占用的问题依然存在。
这里有两种不同的寿命:用户需要持续存在的身份和状态,机器只需要为当前活动提供执行位置。Substrate 将前者建模为 Actor,将后者建模为 Worker Pod。休眠的 Actor 保留记录和快照,恢复时再获得 Worker。池中 Pod 可以继续运行,里面承载的 Actor 则不断更替。
这种复用可以理解为不同 Actor 轮流使用 Worker:Actor A 空闲时保存状态、释放 Worker,Actor B 就可以接着使用;A 下次需要执行时,再分配一个空闲 Worker 恢复状态。因此,需要多少 Worker,主要取决于同时有多少 Actor 在工作。状态保存和恢复需要时间,突发请求也可能让更多 Actor 同时活跃,所以还要预留一些容量。Actor 等待的时间越长,这种复用通常越有价值。
两层控制面的分工
Substrate 的分层落实在资源和存储上:WorkerPool 是 Kubernetes CRD,由 atecontroller 协调成 Deployment;Actor、Worker 记录和 ActorTemplate 则由独立的 gRPC API 管理,持久化到 PostgreSQL。尤其值得注意,ActorTemplate 也不是 Kubernetes CRD。集群控制面看到的是容量池与 Pod,Actor 的高频状态转换留在 Substrate 内部。
但生命周期分离本身,并不必然要求独立 API:也可以用 Actor CRD 表达身份,再由控制器分配已有 Worker。Substrate 更进一步,将 Actor 记录和分配过程移出 Kubernetes API,使大量休眠实例不必逐一成为集群对象,频繁唤醒也无需逐次经过这些对象的写入与控制器协调。代价是自己维护状态存储、并发分配和故障恢复。是否值得这样做,取决于这些管理开销是否已成为瓶颈,以及请求能否接受异步协调的等待;增加一层 API 本身并不会让系统更快。
一次请求沿着这条边界运行:atenet 识别目标 Actor,调用 ResumeActor;控制面为需要恢复的 Actor 选择 Worker,节点上的 atelet 协调 Worker 内的 ateom 恢复 sandbox,路由再把请求转发进去。已有 RUNNING Actor 则直接返回现有分配。这组 API 对应的是 Actor 的状态转换:
可以把 Worker 想成共享工位,Actor 的快照则是收起的工作现场。人离开后工位可以给别人用,工作现场则留待下次展开。
这解释了为什么网络层也是架构的一部分。目标 Actor 可能尚未占有执行位置,请求必须先触发生命周期操作,才能得到可用地址。atenet 的入口实现还包含容量耗尽时的请求等待逻辑;预热容量用完以后,延迟问题仍会回来。所谓快路径,是在已有容量上完成分配与恢复,并不意味着状态读取、快照传输和恢复成本消失了。
调度与快照位置
Kubernetes 决定 Worker Pod 落在哪个 Node;Substrate 则从已运行的 Worker 中,为 Actor 选择满足运行时类型、标签、节点位置和剩余容量要求的执行位置。底层解决 Pod 的资源放置,上层还要保证 Actor 的状态能够在选中的 Worker 上恢复。
状态位置让这层调度有了自己的语义。Substrate 区分 Pause 与 Suspend:前者把快照留在节点本地,恢复调度通过 RequiredNodes 限制到持有快照的节点;后者将快照提交到外部存储,解除这种本地绑定。少搬运状态可以缩短路径,却缩小了可选容量范围。Actor placement 同时是计算放置和状态放置。
例如,一个 Actor 的快照只在 Node A,而 A 上的 Worker 都忙着。即使 Node B 有空闲 Worker,这次恢复仍可能等待;把新 Pod 扩到 B 也没有解决问题。此时需要的是 A 上可用的执行位置,或先将快照转成可跨节点恢复的持久状态,并支付传输成本。由此可以推导,集群的空闲容量,不等于某个 Actor 可用的容量。
这也给两层控制面的协作提出了要求:上层的等待信号需要带上运行时类型、状态位置等约束,才能帮助底层补充真正可用的 Worker。只看总体 CPU 利用率或 Worker 总数,可能出现一边闲置、一边排队。预热容量吸收的是短时突发,扩容补充的是后续供给;两者服务于不同时间尺度。
与 Agent Sandbox 的区别
Kubernetes Agent Sandbox 选择在 Kubernetes API 内表达隔离实例。其 Suspended 语义是终止 backing Pod,保留 Sandbox 身份和持久存储;这并不自动包含进程内存的 checkpoint。Substrate 则把 Actor 状态从 Pod 生命周期中拆出来,利用运行时快照恢复到 Worker。两者解决的问题有交集,但持久目录还在,与进程能从原处继续,是不同的承诺。
Substrate 本身也没有只有一种恢复方式:Full 快照包含进程内存、rootfs 增量及相关持久目录;Data 只保存支持快照的卷数据,恢复可以重新启动进程。不能把所有 suspend/resume 都理解成完整执行现场的延续,更不能据此推导外部 API 调用具备 exactly-once 语义。
对于能从文件或应用状态重建上下文、活动持续时间较长的 Agent,Sandbox CRD 加上会话路由可能已经足够。只有当大量逻辑实例、高比例空闲和频繁恢复共同成为主要成本时,独立管理面才更有理由承担额外复杂度。这是一条需要由负载特征证明的架构边界。
独立控制面的成本
第二层控制面把工作从 Kubernetes 移走,也把责任接了过来。假设 Worker 已经恢复了 Actor,但控制面在记录 RUNNING 之前中断,数据库里还停留在 RESUMING。下一次请求不能因为没看到 RUNNING,就另找一个 Worker 再启动一份;也不能直接认定上一次恢复已经成功。它需要核对原来的分配是否仍有效,并判断执行端究竟完成到了哪一步。
Substrate 的恢复流程先持久化 Worker 分配,再调用节点恢复,最后提交 RUNNING;重新进入 RESUMING 时,会校验并复用有效的原分配。这个顺序给重试留下了依据。但数据库记录与运行时进程并不处于同一个事务中,执行端还需要能识别重复请求,避免重复恢复或覆盖已运行的状态。第二层控制面的难点,是让记录中的状态与实际执行状态在失败和重试后重新一致。 Actor 租约、分配校验和持久化中间状态,都是围绕这个问题展开的。
权限管理也需要跟上这层分工。Kubernetes RBAC 可以约束谁能管理 WorkerPool 等集群资源,但谁能创建、恢复或删除某个 Actor,需要由上层 API 自己判断。把 Actor 移出 Kubernetes API,也意味着要为它建立相应的权限与审计机制。
当大量逻辑实例只间歇执行,而频繁激活与休眠又不适合反复创建、销毁 Pod 时,将逻辑生命周期与物理容量分开管理,就有了实际价值。 Substrate 展示了这条边界如何落到代码里:Kubernetes 维持可用容量,上层管理身份、状态与激活。判断这层设计是否值得,最终要看节省的空闲成本和恢复延迟,能否覆盖快照、容量余量与第二套控制面的代价。