随着大模型推理从单实例逐渐演进到 Prefill/Decode(P/D)分离、KV Cache 传输等复杂形态,“把一个模型 Pod 跑起来”已经不足以描述完整的 serving system。
一个真实的推理系统至少需要解决两类问题:一类是 Workload Management,负责定义实例、拓扑、扩缩、故障恢复和滚动升级;另一类是 Request Routing,负责为请求选择 endpoint,并在 P/D 分离场景下协调 Prefill 与 Decode。
Kthena ModelServing 与 llm-d Router 分别处理这两个层次的问题。本文基于一次真实 GPU 环境实验,使用 Kthena 管理 Qwen3.5-27B 的 Prefill/Decode 拓扑,并接入 llm-d Router,打通从请求路由到跨节点 KV Cache 传输的完整链路。
Router 与 ModelServing:两个不同层次的问题
llm-d Router 面向 Request Plane,主要负责:
- 发现当前可路由的 endpoint;
- 区分 Prefill 与 Decode 实例;
- 为请求选择目标实例;
- 协调一次请求在 Prefill 和 Decode 之间的流转;
- 结合 prefix cache 等信息执行更细粒度的调度。
Kthena ModelServing 面向 Workload Plane,主要负责:
- 定义 Prefill、Decode 等不同 Role;
- 描述多个 Role 组成的 serving topology;
- 维护 Role 与 ServingGroup 的关系;
- 管理副本、调度和实例生命周期;
- 使用 revision 描述 workload 演进,并支持 Role 粒度的更新。
因此,两者不是替代关系,而是清晰分工:
Router 决定一次请求去哪里。ModelServing 决定哪些 serving instance 应该存在,以及它们如何被部署和演进。
这次集成不需要修改 Kthena Controller。llm-d 直接消费 Kthena 写入 Pod 的 workload identity:
modelserving.volcano.sh/name
modelserving.volcano.sh/entry
modelserving.volcano.sh/role
modelserving.volcano.sh/group-name
modelserving.volcano.sh/revision
这组 labels 构成了两个系统之间的接口。Router 不需要理解 Kthena 如何完成 rollout、recovery 或副本管理,Kthena 也不需要把某种 Router 策略固化到 workload controller 中。
用 ModelServing 表达真实 P/D 拓扑
实验运行在 Kubernetes 1.36 集群上,模型为 Qwen3.5-27B,推理引擎使用 vLLM 0.27.0。Prefill 和 Decode 分别运行在两个 NVIDIA L2 GPU 节点,每个 Role 使用 4 张 GPU:
| Role | Node | GPU | Parallelism | Port |
|---|---|---|---|---|
| Prefill | 192.168.2.183 | NVIDIA L2 × 4 | TP4 | 8000 |
| Decode | 192.168.2.134 | NVIDIA L2 × 4 | TP4 | 8200 |
KV Cache 传输使用 vLLM NixlConnector,跨节点数据通路使用 UCX,模型最大上下文长度设置为 131072。
在 Kthena 中,Prefill 和 Decode 被表达为同一个 ModelServing 下的两个 Role:
spec:
  template:
    roles:
      - name: prefill
        replicas: 1
        ...
      - name: decode
        replicas: 1
        ...
Prefill 侧配置为 KV producer:
--tensor-parallel-size 4
--kv-transfer-config '{
  "kv_connector": "NixlConnector",
  "kv_role": "kv_producer",
  "engine_id": "qwen38-prefill",
  "kv_connector_extra_config": {
    "backends": ["UCX"]
  }
}'
Decode 则使用:
--port 8200
--tensor-parallel-size 4

--kv-transfer-config '{
  "kv_connector": "NixlConnector",
  "kv_role": "kv_consumer",
  "engine_id": "qwen38-decode",
  "kv_connector_extra_config": {
    "backends": ["UCX"]
  }
}'
最终 Pod identity 类似于:
Prefill
  entry=true, role=prefill
  group=vllm-qwen38-27b-pd-0
  revision=678d977c6d

Decode
  entry=true, role=decode
  group=vllm-qwen38-27b-pd-0
  revision=5f55b4d589
这里 Kthena 提供的价值首先体现在 topology abstraction 上。
Prefill 和 Decode 不再只是两个彼此无关的 Pod,而是 ModelServing 中两个具有明确语义的 Role。Controller 进一步将这种语义写入运行时 Pod identity。role 表示实例在 serving topology 中承担 Prefill 还是 Decode;group-name 描述这些 Role 是否属于同一个 ServingGroup;revision 描述各个 Role 当前所处的 workload 版本。
Decode Sidecar:统一 Entry Endpoint
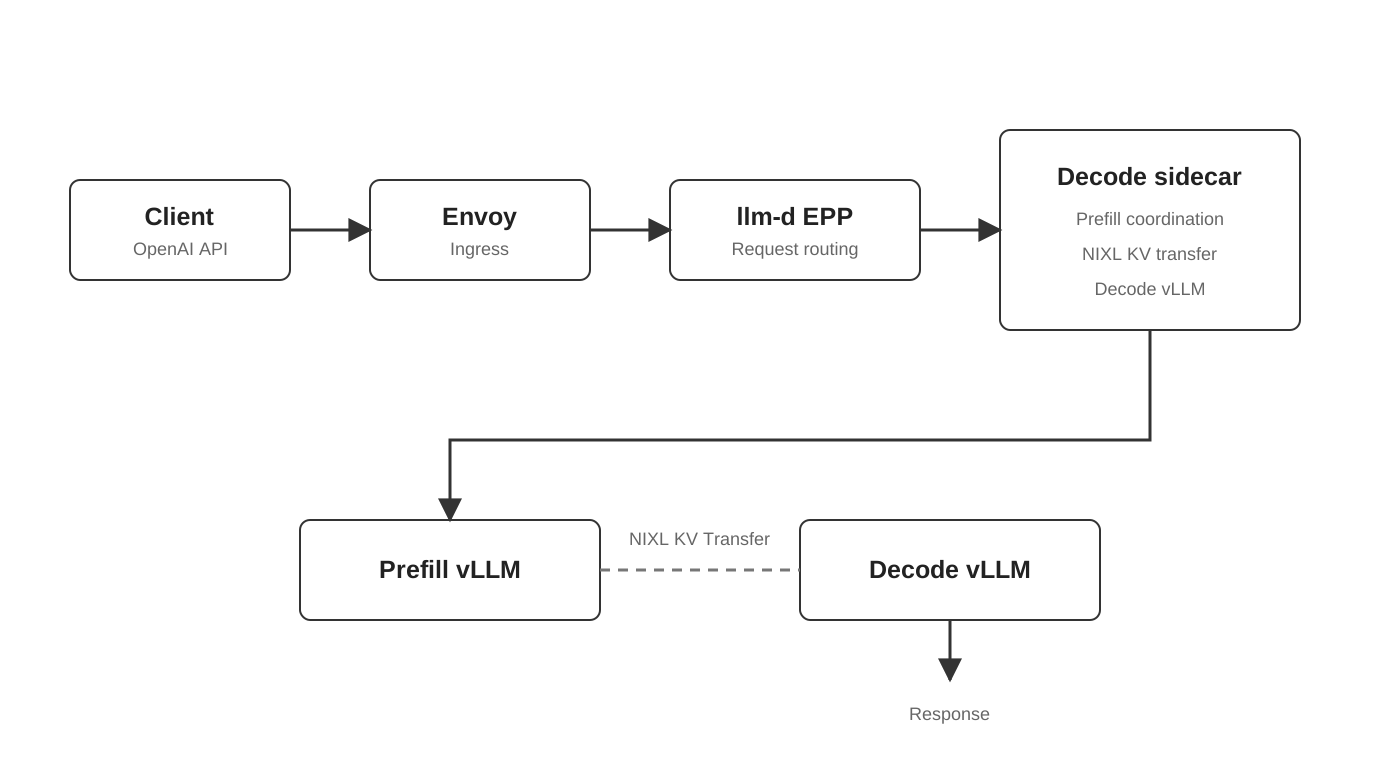
P/D 请求并不是简单地向两个 HTTP endpoint 各发一次请求。Decode 侧需要一个组件协调两个阶段:先向 Prefill 发起请求并取得 KV Transfer metadata,再构造 Decode 请求,最后把 Decode 的结果返回给客户端。
因此,Decode Role 中加入 llm-d-router-disagg-sidecar:
image: ghcr.io/llm-d/llm-d-router-disagg-sidecar:v0.10.0
args:
  - --port=8000
  - --model-server-port=8200
  - --kv-connector=nixlv2
  - --secure-proxy=false
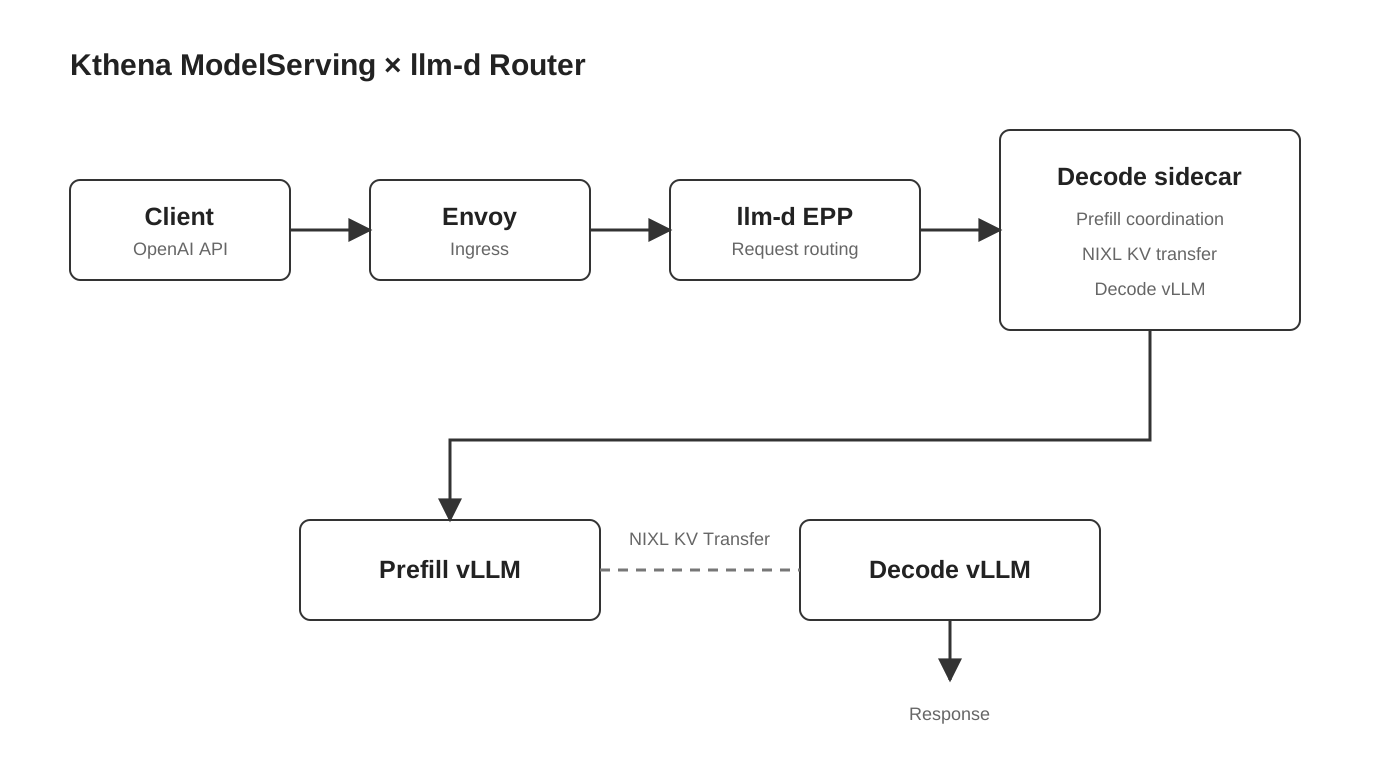
Decode vLLM 改为监听 8200,由 sidecar 对外接管 8000。于是 Router 看到的 endpoint 保持一致,具体端口关系见上图。
P/D 协调细节被封装在 Decode entry 中,Kthena 仍然只需要管理一个具有明确语义的 Decode Role。
llm-d 如何发现并选择 Kthena 实例
llm-d standalone Router 由 Envoy 和 EPP(Endpoint Picker)组成。Envoy 承接外部流量,EPP 根据 endpoint 信息执行选择。
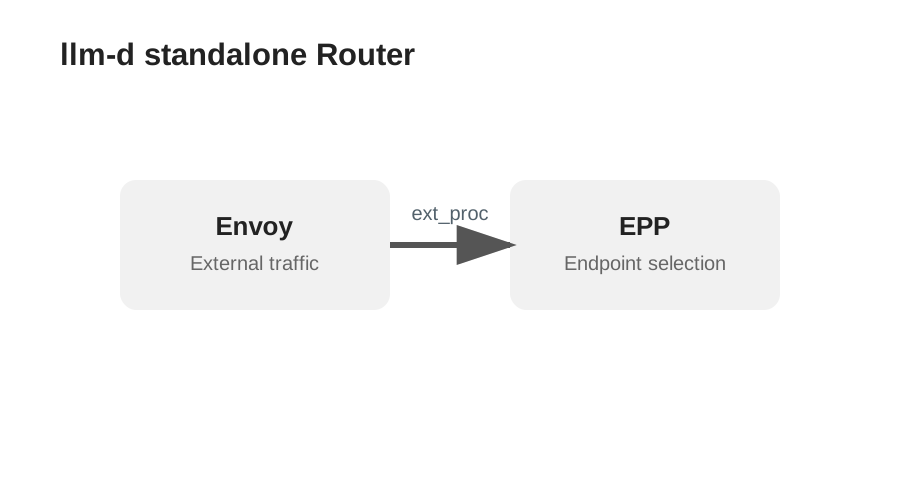
llm-d 与 Kthena 对接的关键不是增加新的耦合 CRD,而是直接使用 Kthena labels:
modelServers:
  matchLabels:
    modelserving.volcano.sh/name: vllm-qwen38-27b-pd
    modelserving.volcano.sh/entry: "true"
  type: vllm
  protocol: http
  targetPorts:
    - number: 8000
name 将 endpoint 限定在目标 ModelServing,entry=true 则避免把 worker Pod 当成 HTTP endpoint。随后 EPP 通过 role 区分 P/D:
- type: label-selector-filter
  name: kthena-prefill
  parameters:
    matchExpressions:
      - key: modelserving.volcano.sh/role
        operator: In
        values: [prefill]

- type: label-selector-filter
  name: kthena-decode
  parameters:
    matchExpressions:
      - key: modelserving.volcano.sh/role
        operator: In
        values: [decode]
而 ServingGroup 则进一步参与 topology screening:
- type: disaggregatedset-rollout-screener
  name: kthena-serving-group
  parameters:
    scope:
      labelSelector: >
        modelserving.volcano.sh/name=vllm-qwen38-27b-pd,
        modelserving.volcano.sh/entry=true

    revisionGating:
      mode: max-role
      requireRoles:
        values: [prefill, decode]

      revisionLabelKey:
        modelserving.volcano.sh/group-name

      roleLabelKey:
        modelserving.volcano.sh/role
这意味着 Router 看到的不再是一组缺少语义的 Pod IP。Kthena 先负责把 serving topology 转化为稳定的 workload identity;llm-d 再基于这些 identity 完成 request scheduling。
Role 级更新:ModelServing 的生命周期价值
为了接入 llm-d,本次实验只修改了 Decode Role:增加 routing-sidecar,并将 vLLM 端口从 8000 调整到 8200。更新后,Decode 进入新 revision,而未修改的 Prefill 保持原 revision 和运行状态:
NAME                               ROLE      REVISION
vllm-qwen38-27b-pd-0-decode-0-0    decode    5f55b4d589
vllm-qwen38-27b-pd-0-prefill-0-0   prefill   678d977c6d
这说明在 ModelServing 中,Role 不只是一个 label,而是 workload lifecycle 的一等管理单元。
对于 P/D serving topology,这一点非常关键。如果 serving system 由多种职责不同的实例组成,配置变更不应该天然等价于“整体重启”。Prefill、Decode 以及未来可能出现的其他 Role,都应该能够按照自身变化独立演进。
从一次失败到真实的 NIXL P/D 链路
实验中还验证了一个重要事实:HTTP 200 并不等于 P/D 数据路径成功。 初次跨节点传输出现 handshake_setup_failed 和 NIXL_ERR_BACKEND,说明 Prefill 请求虽然能够完成,但 Decode 尚未真正消费到远端 KV。
随后将 UCX 网络配置收敛到实际使用的网卡和传输协议:
UCX_NET_DEVICES=eth0
UCX_TLS=tcp,cuda_copy
修复后,NIXL error check 为 NONE,Prefill 返回 KV metadata,Decode 完成 KV 消费并生成结果。这个过程验证的不是两个 HTTP server 都能返回 200,而是上图所示的完整数据通路。
完整 E2E 验证
完成 Kthena ModelServing 与 llm-d Router 配置后,通过 Envoy 发送标准 OpenAI Chat Completion 请求。
最终请求链路如下:
成功请求返回:
{
  "model": "qwen38-27b",
  "content": "llmd-pd-ok",
  "finish_reason": "stop",
  "system_fingerprint": "vllm-0.27.0-tp4-396e4bd4",
  "usage": {
    "completion_tokens": 6,
    "prompt_tokens": 21,
    "total_tokens": 27
  }
}
同时,Prefill 日志确认收到请求并返回 200,Decode 侧没有出现 NIXL transfer error。
因此,本次实验验证的不是简单的 HTTP endpoint 连通,而是:
- Kthena 创建并管理真实 Prefill / Decode topology;
- 两个 Role 分布在不同 GPU 节点;
- llm-d 通过 Kthena labels 自动识别 entry、Role 与 ServingGroup;
- Prefill 与 Decode 之间完成真实跨节点 NIXL KV Cache 传输;
- 最终请求通过标准 OpenAI API 返回结果。
总结
Kthena 接入 llm-d 并不是简单地在 ModelServing 前面挂一个 Router,而是将推理系统中的两个层次解耦:
- llm-d 负责 endpoint discovery、Prefill/Decode selection、prefix-aware routing 和 P/D request coordination;
- Kthena 负责多 Role serving topology、ServingGroup、实例调度、revision、Role-level rollout,以及后续的 recovery 和弹性扩缩。
二者通过 Kubernetes labels 建立接口,而不是通过 Router-specific controller 形成强耦合。这样,上层可以接入 llm-d 或其他 Router,底层的 Role、ServingGroup、Revision 与生命周期仍由 ModelServing 统一管理。
Router 决定请求流向,Kthena 决定 Serving Topology 的存在方式和演进方式。