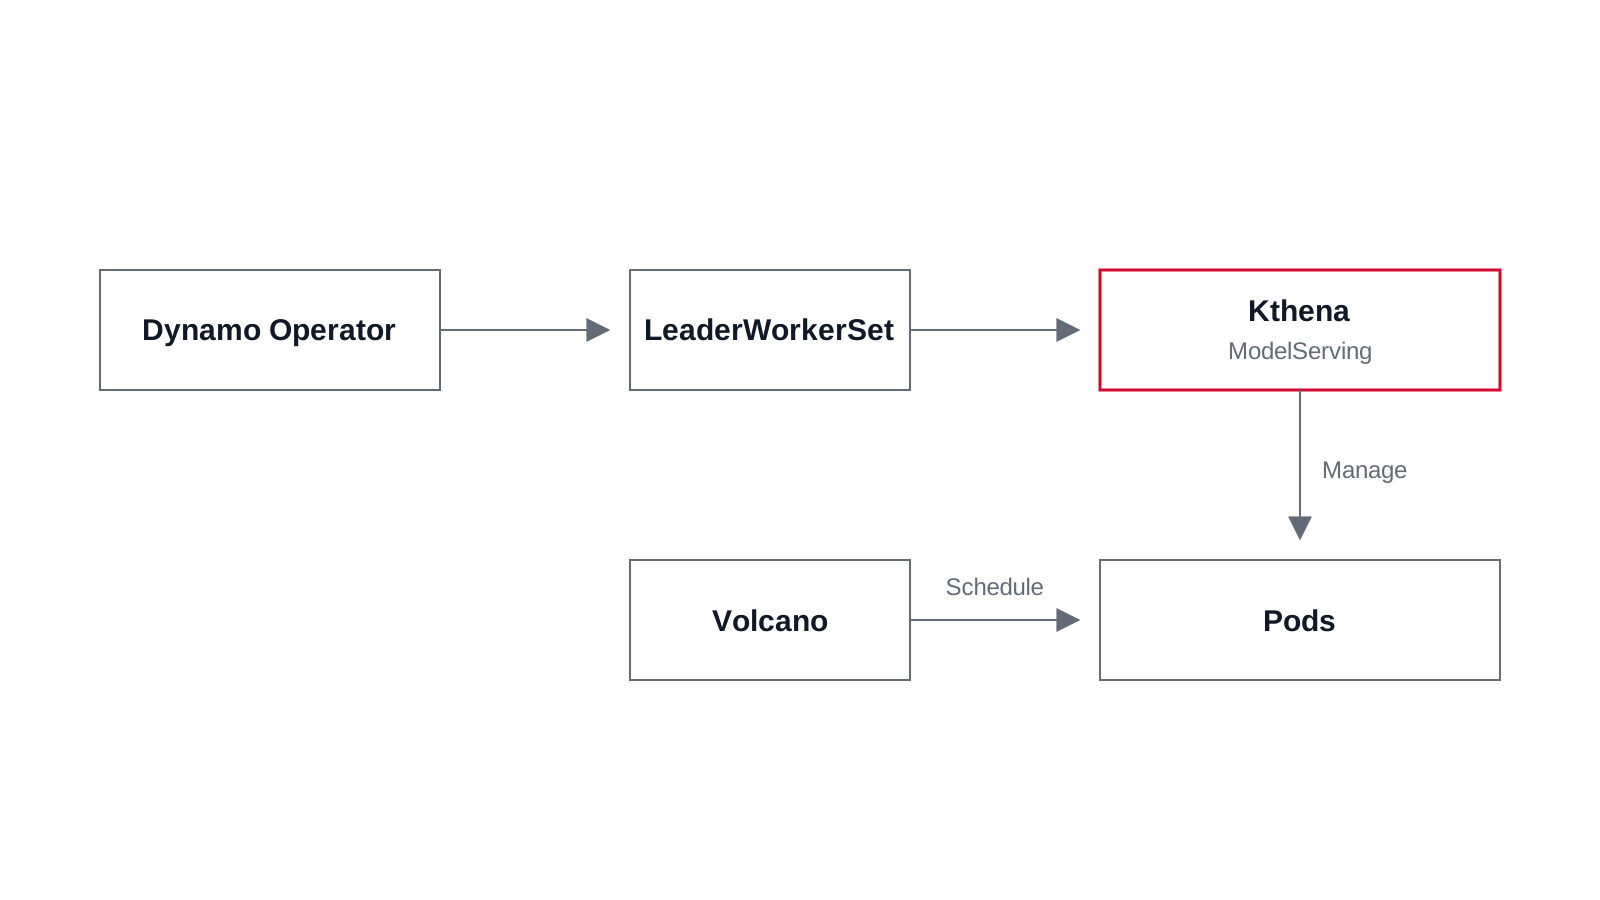
一个跨多台机器运行的模型,在 Kubernetes 中表现为多个 Pod,在推理引擎中却可能只是一个实例。部署系统需要管理这些 Pod 的创建、更新与恢复;运行时需要让进程彼此发现、共同计算。两者面对同一批进程,使用的管理单位却未必相同。
LWS 把一组 Pod 定义为可复制的实例,Dynamo 组织请求在推理组件之间的执行,Kthena 的 ModelServing 则通过 ServingGroup 和 Role 表达工作负载关系。理解它们如何组合,可以先从一个具体问题开始:哪些关系需要在部署时确定,哪些关系适合留给运行时?
LWS、Dynamo 与 Kthena
LWS:多机副本管理
LeaderWorkerSet 的出发点很具体:一个模型实例可能需要多个 Pod 合作,扩容时需要复制的是整组实例。replicas: 2、size: 4,表达的是两组实例,每组一个 leader、三个 worker,共八个 Pod。
原生 LWS 控制器通过两层 StatefulSet 组织这些 Pod:一个 StatefulSet 管理各组 leader,每个 leader 再对应一组 worker。稳定的序号和网络身份,让进程知道自己是谁、同组成员在哪里;组级更新与恢复策略,则把多个进程的命运联系起来。这里的 leader 是工作负载中的角色,不应直接理解成共识系统里经过选举产生的主节点。1
LWS 给出了一个清晰的复制单位。至于这些进程如何切分模型、交换张量,以及怎样处理用户请求,还需要运行时与调度体系共同完成。理解这个分工,有助于避免把“组存在”与“组能高效工作”混为一谈。
Dynamo:分布式推理
NVIDIA Dynamo 面向分布式推理。可以从两个方向理解它。
沿请求看,Frontend 处理入口与预处理,路由逻辑选择 worker,后端推理引擎执行计算。在 Prefill/Decode 分离的形态下,还需要协调阶段之间的 KV cache 传输;NIXL 可以承担相关数据传输。Dynamo 也提供运行时发现与通信机制,以及根据运行信号调整容量的 Planner。2
沿部署看,Dynamo Operator 把推理应用的组件表达落到 Kubernetes 工作负载。这里讨论的是它的 LWS 多节点路径:图级对象 DynamoGraphDeployment(DGD)向下形成组件级对象 DynamoComponentDeployment(DCD),多节点组件再生成 LWS。其他部署路径也存在,因此不能把 LWS 当作 Dynamo 唯一的底座。3
这两个方向需要一起看。只把 Dynamo 理解成推理引擎,会漏掉它的部署与容量控制;只看 Operator,又容易忽略真正影响延迟的请求路由、缓存与执行过程。
Kthena:推理工作负载编排
Kthena 的 ModelServing 以 ModelServing → ServingGroup → Role 描述工作负载。一个 ServingGroup 可以包含 Prefill、Decode 等不同 Role;一个 Role 实例又可以包含 Entry 与 Worker Pod。这让实例内部协作关系有机会进入 Kubernetes 的声明式管理,并衔接 Volcano 的组调度与拓扑能力。4
从这套结构看,Kthena 关心的不只是单个 Pod 的期望数量,还包括 Pod 之间的角色关系。这些关系一旦进入工作负载模型,就可以参与更新、恢复和资源分配。关系表达得多细,也会影响用户需要提前作出多少部署决策。
LWS 与 ModelServing
在 Dynamo 的 LWS 路径中,DGD、DCD 描述图与组件,多节点组件以 LWS 表达。Kthena 可以接管这些 LWS,将它们转换为 ModelServing,再管理 Pod 并衔接 Volcano;这一组合由 Kthena 承担协调,不同时运行原生 LWS 控制器和 webhook。5
同一个工作负载 API,可以有不同的底层实现。LWS 对使用者暴露组、成员和生命周期,Kthena 则用自己的模型组织执行。原生 LWS 的 StatefulSet 层次不必被照搬,但进程赖以启动的身份与地址、上层赖以推进部署的状态,仍需要保持一致。
这给 Kthena 留出了实现上的空间,也划出了一条责任边界:工作负载控制器可以决定怎样维持一组进程,却不能随意改变这组进程理解自身的方式。某些看似普通的环境变量和 DNS 名称,实际参与了分布式实例的形成。
模型的统一与执行的统一,也可以分开考虑。不同运行时可以进入同一套工作负载管理,而继续保留自己的通信、缓存和请求处理方式。对平台而言,复用的范围落在生命周期与资源管理;对运行时而言,专有知识仍然留在最接近计算的位置。
一个完整的运行闭环
一个两节点 workload 经由真实 Dynamo Operator 生成 LWS,Kthena 接管后,对象链按下面的关系收敛:
flowchart LR
  DGD["DynamoGraphDeployment"] --> DCD["DynamoComponentDeployment"]
  DCD --> LWS["LeaderWorkerSet"]
  LWS --> MS["Kthena ModelServing"]
  MS --> PG["Volcano PodGroup"]
  MS --> Pods["Pods"]
  PG -. gang scheduling .-> Pods
对象状态可以直接从集群中看到:
$ kubectl get dynamographdeployments,dynamocomponentdeployments -n dynamo-demo
NAME                                                READY   BACKEND   AGE
dynamographdeployment.nvidia.com/kthena-lws-smoke   True    sglang    28s

NAME                                                                    AVAILABLE   BACKEND   AGE
dynamocomponentdeployment.nvidia.com/kthena-lws-smoke-decode-050b6b6c   True        sglang    28s
dynamocomponentdeployment.nvidia.com/kthena-lws-smoke-frontend          True        sglang    28s

$ kubectl get leaderworkersets,modelservings,podgroups -n dynamo-demo
NAME                                                                          READY   DESIRED   UP-TO-DATE   AGE
leaderworkerset.leaderworkerset.x-k8s.io/kthena-lws-smoke-decode-050b6b6c-0   1       1         1            28s

NAME                                                                          AGE
modelserving.workload.serving.volcano.sh/kthena-lws-smoke-decode-050b6b6c-0   28s

NAME                                                                  STATUS    MINMEMBER   RUNNINGS   AGE
podgroup.scheduling.volcano.sh/kthena-lws-smoke-decode-050b6b6c-0-0   Running   2           2          28s

$ kubectl get pods -n dynamo-demo -l nvidia.com/dynamo-component=decode
NAME                                               READY   STATUS    RESTARTS   AGE
kthena-lws-smoke-decode-050b6b6c-0-0-default-0-0   1/1     Running   0          59s
kthena-lws-smoke-decode-050b6b6c-0-0-default-0-1   1/1     Running   0          59s
运行时契约也保持一致:两个 Pod 收到相同的 LWS_LEADER_ADDRESS 和 LWS_GROUP_SIZE=2,leader 与 worker 的 LWS_WORKER_INDEX 分别为 0 和 1。leader 使用 <lws-name>-0.<lws-name>.<namespace>,worker 使用 <lws-name>-0-1.<lws-name>.<namespace>,与 Dynamo TRT-LLM 从 leader 地址推导 worker 地址的规则一致。删除 LWS headless Service 后,Kthena 收到 Service 事件并将其重新创建。
ModelServing 的表达范围
ModelServing 能表达多个 Role,但 LWS 输入本身没有携带完整的 Dynamo 图语义。
在 LWS 转换实现中,一个 LWS 被映射为一个 ModelServing:LWS 的副本数对应 ServingGroup 数量,每组包含一个 default Role;leader 对应 Entry,剩余成员对应 Worker。这个映射保留了多机实例的结构。6
如果 Dynamo 分别为两个多节点组件生成 LWS,Kthena 收到的就是两个工作负载。即便内部模型足以表达更丰富的协作关系,控制器仍需要额外的信息,才能理解这些组件之间的关系。
组件各自获得管理,与整个推理图获得协同调度,是两个层次的能力。跨组件亲和、统一容量约束或协同更新,都需要把组件之间的关系明确交给负责决策的系统。
可能是由上层显式传递关系,也可能是以额外策略对象描述关联,还可能直接采用原生 ModelServing 表达。每一种选择都在重新分配复杂度:上层知道得更多,耦合也更深;底层推断得更多,错误解释的风险也更大。
更丰富的模型提供了更多表达空间,也要求使用者作出更多选择。若一种关系只在运行时短暂形成,把它固化到部署对象中,可能会缩小运行时的选择范围;若一种关系长期稳定而且影响放置,让编排层看见它,又可能省去反复试探的成本。
ServingGroup 的分组方式
推理服务中,至少存在三种不完全重合的关系。
第一种是计算依赖。一组模型并行进程,可能需要共同参与计算,缺少一个成员就无法工作。
第二种是请求协作。一次请求先经过 Prefill,再交给 Decode;两者需要合作,但不一定永久绑定为固定的一对。
第三种是资源竞争。多个服务可能共享队列、设备和网络,它们互不调用,却共同影响容量与延迟。
当这些关系被映射为一个“组”时,组的语义就会决定系统怎样扩容、怎样调度、怎样失败。
把 Prefill 与 Decode 放进同一个 ServingGroup,可以让局部关系更直接,也可能便于表达联合约束。如果采用共享池,多个 Prefill 与多个 Decode 动态组合,又可能提高容量调节的自由度。此时,将每个请求会经过的组件都绑定为一个固定生命周期单元,未必符合运行时的实际组织方式。
对 Kthena 而言,ServingGroup 提供了组织关系的能力;如何选取边界,仍取决于服务形态。名字叫“完整服务”的单元,在直接部署时可能对应完整推理实例,在 LWS 路径中也可能只承载图中的一个多机组件。读懂这个上下文,比给所有实例套用同一种分组方式更有用。
这也引出一个恢复问题:某个 Decode 实例失败时,应该只修复它,还是重建与它相关的一组进程?需要一起恢复的范围,究竟由进程间的强依赖决定,还是由当前部署对象的边界决定?两者一致时系统很自然;不一致时,就需要额外的协调或更细的模型。
控制器的分工
Kthena 对 LWS 的处理是单向同步:变更从 LWS 向下传播到 ModelServing。7在 Dynamo 场景中,LWS 又可能由上层 Operator 生成。因此,调整配置时需要沿着这条关系找到源头,直接修改生成的 ModelServing,可能会被后续协调覆盖。
扩缩容也需要明确分工。Dynamo Planner 与 Kthena Autoscaler 都有各自的使用场景;组合使用时,同一份副本配置应有明确的控制来源。Kthena 负责落实工作负载的期望,并不意味着所有容量决策都需要由它承担。
编排与调度
Kthena 用 ServingGroup 和 Role 描述哪些进程需要协作,Volcano 根据资源与拓扑约束安排它们的位置。对多机实例而言,这能让调度考虑整组工作负载,而不只是分别寻找能够容纳单个 Pod 的节点。
放置得更近可能减少通信开销,但也可能限制可用资源的选择。是否需要严格的拓扑约束,仍取决于模型的并行方式和集群条件。Kthena 提供表达这些关系的方式,具体约束则需要结合部署场景选择。
请求到来后的 worker 选择、缓存使用与计算过程,仍属于运行时的职责。工作负载被合理放置,是推理服务运行的基础;服务表现还需要结合实际请求观察。
工作负载状态
Pod 已经启动,不一定意味着模型已经能够接收请求。进程会合、模型加载和就绪检查,都可能发生在启动之后。
对 Kthena 来说,除了创建和恢复工作负载,还需要把它们的状态反馈给上层。副本数、可用数量与更新进度,让上层知道期望是否已经落实。保留这一分工,也能让 Dynamo 继续从自身的组件视角管理服务。
Kthena 的职责边界
从这套组合看,Kthena 的作用主要落在工作负载编排:通过 Role 和 ServingGroup 组织进程,管理它们的生命周期,并把分组与拓扑关系交给调度系统。
LWS 提供多机实例的表达,Dynamo 保留对推理执行的理解。Kthena 可以复用这些已有能力,同时为集群中的工作负载提供统一的管理方式。是否把更多关系纳入 ModelServing,可以从具体场景判断:这段关系是否影响共同更新、故障恢复或资源放置?如果只是随请求变化的临时组合,留给运行时处理也许更自然。